BLOG POST
ハーネスエンジニアリングとは? ― AIを「指示する」から「環境で導く」へ
By 中野 健太朗 · 約24分で読めます
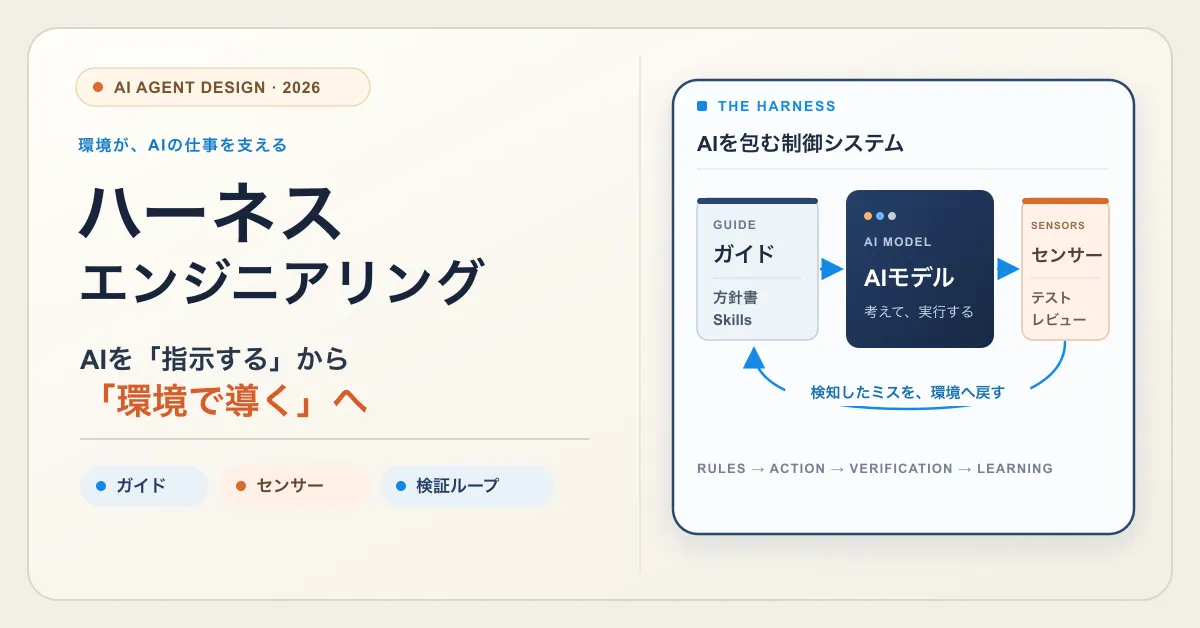
「プロンプトはかなり工夫しているのに、AIが毎回同じところでミスをする」
Claude CodeやChatGPT(Codex)を業務で使い込んでいる方から、よく聞く悩みです。指示の言い回しを変え、具体例を足し、何度もやり直させる。それでも新しいセッションを開くと、また同じ失敗を繰り返します。
結論から言うと、この問題はプロンプト(指示)の上手さでは解決しません。直すべきなのはAIモデルの外側にある「環境」のほうです。 AIが働く環境そのものを設計し、ミスが起きないように土台と検証の仕組みを整える。この考え方こそが、2026年に急速に広まり実務の共通言語になりつつある「ハーネスエンジニアリング(Harness Engineering)」です。
現在ではLangChainの解説でも整理されている通り、「Agent = Model + Harness(エージェントの力はモデル単体ではなく『モデル+環境』で決まる)」という式で語られることも増えました。
参考資料
The Anatomy of an Agent Harness
Learn how agent harnesses transform AI models into autonomous work engines. Explore core components: filesystems, sandboxes, and memory.
blog.langchain.com
2026年前半にはOpenAIやAnthropicらが相次いで実践知を公開し、さらに後半にかけては「やりすぎた重いハーネスはむしろ性能を落とす」という教訓まで出揃っています。
本記事では、ハーネスエンジニアリングとは何か、プロンプトエンジニアリングとの違い、ガイドとセンサーの仕組み、やりすぎを防ぐ設計原則、そしてKCPの実例について紹介していきます。
1. ハーネスエンジニアリングとは何か
定義 ― AIモデルを「包み込む」外側のインフラ
ハーネスエンジニアリングとは、AIエージェントが環境を認識し、行動を選び、出力を検証して軌道修正する「外側の制御システム(インフラ)」を設計し、ミスのたびに改善し続ける営みです。
中心にあるのが「ハーネス(Harness)」という概念です。 Google DeepMindのPhilipp Schmid氏はハーネスを次のように定義しています。
「長時間実行されるタスクを管理するためにAIモデルを包み込むインフラストラクチャのことである。これはエージェントそのものではない。エージェントの動作を制御し、その信頼性・効率性・制御性を確保するソフトウェアシステムである。」
具体的には方針書やプロンプトのプリセット、ツール呼び出しの制御、ファイルや記憶の永続化、ライフサイクルフック、サブエージェントの管理、終了条件の検証といった機能をすぐ使える形でまとめた土台がハーネスです。Schmid氏はこれをコンピュータに例えて、モデルがCPU、コンテキストウィンドウがRAM(短期記憶)、ハーネスがOS、エージェントがその上で動くアプリケーションだと整理しています。
参考資料
The importance of Agent Harness in 2026
In 2026, Agent Harnesses will become essential for building reliable AI systems that can handle complex, multi-day tasks.
www.philschmid.de
そもそも英語の「harness」は馬具を指します。 馬が全力を出し、かつ意図した方向に走れるようにするための道具です。AIに対するハーネスも、まったく同じ役割を果たします。
AIエージェントがシェフ、ハーネスが調理場
もう少し直感的なたとえに置き換えましょう。LayerXの福島良典氏はこの関係を「AIエージェントがシェフであり、ハーネスが調理場」と表現しています。

福島良典 | LayerX
@fukkyy

記事エージェントハーネスとAIマネージドサービス
1,635
どれだけ腕の良い三つ星シェフを連れてきても、包丁がどこにあるか分からず、コンロの火力が不安定で食材が古いままの厨房では良い料理は作れません。 AIの現場でも同じことが起きています。
ここで重要なのは役割分担です。 シェフ(AIモデル)の能力を引き上げるのは、AnthropicやOpenAIといったモデル開発企業の仕事です。一方で、調理場(ハーネス)を自社の業務に合わせて整えるのは、AIを使う側の仕事になります。 どれほど賢い新モデルが出ても、自社のルールや検証環境が整っていなければ、その性能は引き出せません。
2026年に一気に広まった3つの転換点
この概念が2026年に一気に実務の共通言語となった背景には、3つの大きな節目がありました。
① 「プロンプト」から「環境の恒久修正」へ
HashiCorp共同創業者のMitchell Hashimoto氏がブログ「My AI Adoption Journey」で、AI活用の第5段階として「Engineer the Harness」を提唱しました。 エージェントがミスをするたびにチャットで指摘して終わらせるのではなく、二度と同じミスをしないよう環境に恒久的な修正を加えるという実践知です。
参考資料
My AI Adoption Journey
mitchellh.com
② 手動コード0行・100万行の実証
OpenAIのエンジニアリングチームは少人数(3〜7名)がCodexを使い、約5ヶ月間で手動のコードを1行も書かずに約100万行・約1,500本のPRを本番出荷した事例を公開しました。 エンジニアの主戦場が「実装を書く」から「環境・仕様・検証ループを設計する」へ移った(“Humans steer. Agents execute.”)ことを示した象徴的な記録です。
参考資料
Harness engineering: leveraging Codex in an agent-first world
How OpenAI's engineering team built and shipped an internal product with zero lines of manually written code using Codex and harness engineering.
openai.com
③ 長時間実行と制御ループの体系化
Anthropicは数時間に及ぶアプリ開発の実験から、コンテキスト肥大に伴う品質低下や「甘い自己採点」を防ぐハーネス設計を公開しました。
参考資料
Harness design for long-running apps
Anthropic is an AI safety and research company that's working to build reliable, interpretable, and steerable AI systems.
www.anthropic.com
続いてThoughtworksのBirgitta Böckeler氏(martinfowler.com)がこれらを「事前制御(ガイド)」と「事後検知(センサー)」の制御ループとして整理し、実務のフレームワークが定着しました。
参考資料
Harness engineering for coding agent users
A mental model for building trust in coding agents through feedforward guides, feedback sensors, and iterative harness engineering.
martinfowler.com
2. プロンプト・コンテキスト・ハーネスの3階層
ハーネスエンジニアリングを正しく位置づけるには、よく似た3つの言葉との違いを押さえる必要があります。 「プロンプトエンジニアリング」「コンテキストエンジニアリング」、そして「ハーネスエンジニアリング」です。
データガバナンス企業Atlanの整理でも示されている通り、この3つは対立するものではなく、制御する範囲の広さ(単位)が違う入れ子構造になっています。
参考資料
Prompt vs Context vs Harness Engineering: Key Differences
Prompt engineering, context engineering, harness engineering: three disciplines, three failure modes. Learn where each layer breaks down and how Atlan's Context Layer ships with Context Agents that continuously validate definitions, ownership, and lineage across 100+ connectors , ensuring the data estate that prompt, context, and harness operations run against is governed and semantically consistent before any agent call executes.
atlan.com
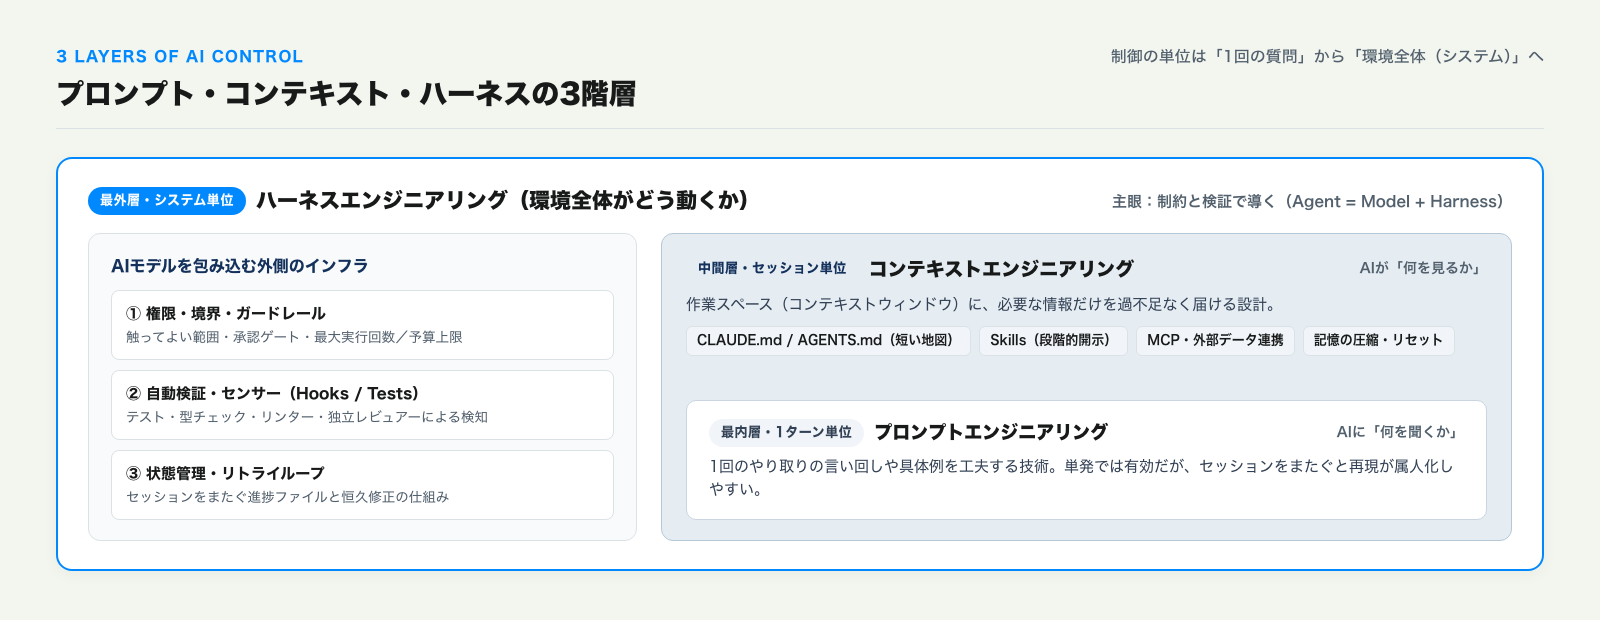
| 階層 | 制御する対象 | 単位 | 主眼 | 典型的な失敗 |
|---|---|---|---|---|
| プロンプトエンジニアリング | AIに「何を聞くか」 | 1回のやり取り(1ターン) | 指示・例の工夫 | セッションが変わると忘れる・属人化する |
| コンテキストエンジニアリング | AIに「何を見せるか」 | セッション(会話)単位 | 情報の選別・圧縮 | 情報不足や古い資料で的外れな回答をする |
| ハーネスエンジニアリング | 環境「全体」がどう動くか | システム単位 | 境界・検証・ループ | 暴走・手抜き完了・自己採点の過信が起きる |
プロンプトは「1回の質問の言い回しを磨く技術」、コンテキストは「AIの視界(コンテキストウィンドウ)に適切な情報だけを過不足なく載せる技術」です。 そしてハーネスは、コンテキストの出し入れに加えて、権限境界・ツール・記憶の永続化・自動テスト・承認ゲートまでを含めた「システム全体」を設計します。
プロンプトが「いかに上手にお願いするか」だとすれば、ハーネスは「いかに外れてはいけない枠と確かめる仕組みを環境に埋め込むか」です。
データが示す「モデルではなく環境で壊れる」理由
「賢いモデルを使えば解決するのでは?」という疑問に対し、各種の分析はこのような現実を示しています。
Atlanが企業のAIエージェント失敗事例を分析した分類では、本番運用で起きる失敗の要因はモデルそのものではなく、**設計段階の構造欠陥(約20%)・実行やツール連携の不具合(約25%)・古い情報や定義ズレなどのデータ/文脈層(約55%)**に集中しています。 つまり、モデルのせいに見える失敗の大半は実はモデルに渡している文脈や実行環境の欠陥です。
さらに厄介なのが、エージェントの作業が長時間化・多段階化している点です。 たとえば1ステップの成功率が85%という高い水準でも、10ステップ連続で成功する確率は乗算で低下し、**約20%(0.85の10乗 ≒ 19.7%)**まで落ち込みます。 実際、2026年のベンチマーク「APEX-Agents」でも、エージェントが最初の試行でタスクを完了できる割合は24%にとどまると報告されています。 経営面でも、Gartnerは2027年末までにエージェンティックAIプロジェクトの40%以上がコストやリスク管理の不備により中止されると予測しています。
参考資料
AI Agent Harness Failures: 13 Anti-Patterns and Root Causes
Most AI agent projects die before production, and most die in the data layer. Learn 13 named anti-patterns across architectural, execution and data-layer tiers, and how to fix them.
atlan.com
だからこそ、途中でズレを検知し、その場で軌道修正させるハーネスが不可欠になります。
3. ハーネスの中身:「ガイド」と「センサー」の2輪で回す
では、具体的にハーネスの中に何を作ればよいのでしょうか。ここで非常に役に立つのが、第1節で紹介したThoughtworksのBirgitta Böckeler氏が提唱した「ガイド(Feedforward)とセンサー(Feedback)」の考え方です。
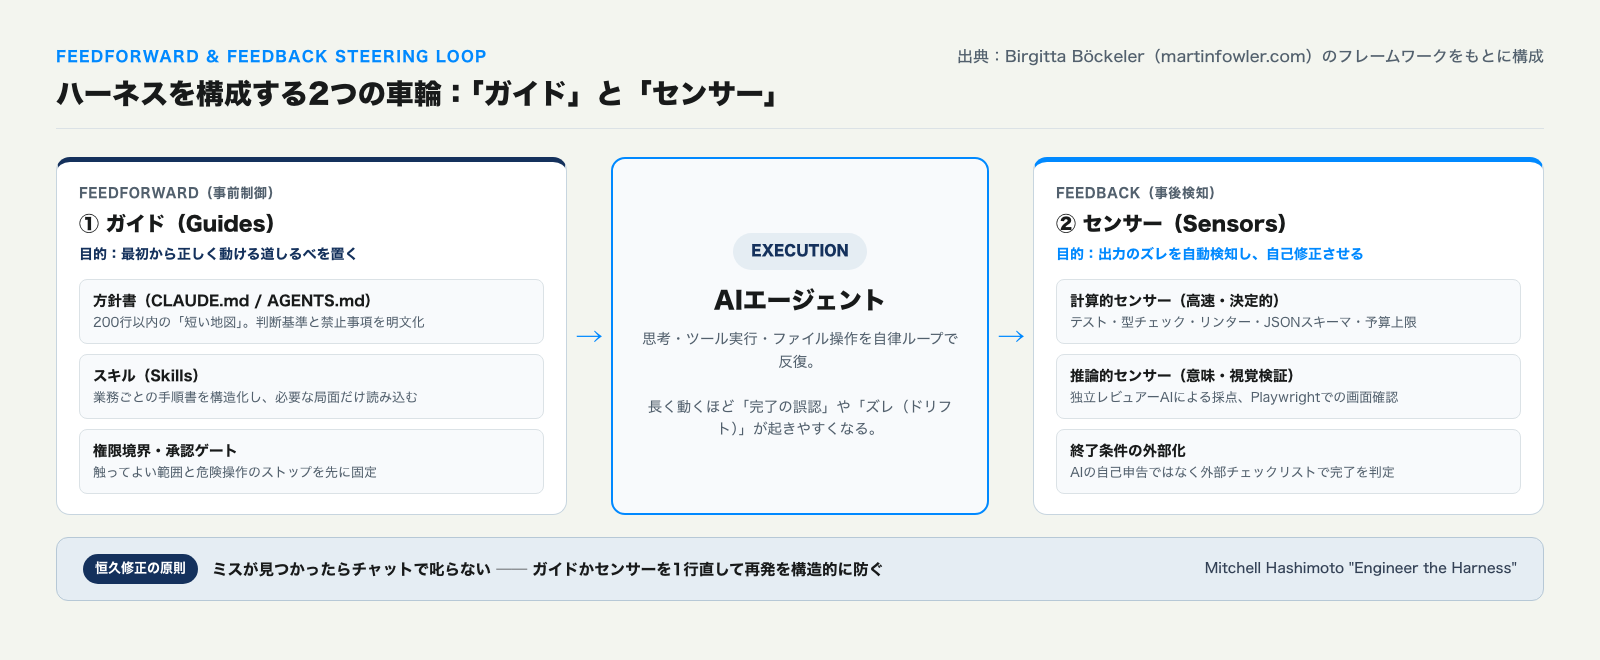
人間が優秀な新人に仕事を任せるときと同じで、良いハーネスは「事前に道しるべを示す(ガイド)」と「実行後に間違いを検知して直させる(センサー)」の2輪で回ります。片方だけでは機能しません。
① ガイド(事前制御):最初から外さない道しるべ
AIが動き出す前に読み込ませたり、環境として固定したりする仕組みです。
- 短い方針書(
CLAUDE.md/AGENTS.md): 判断基準や禁止事項、リポジトリの構造を記した土台です。OpenAIが「1,000ページのマニュアルではなく地図を渡せ」と指摘している通り、ここを分厚くするとAIは指示を見落とします。Claude Codeの公式ガイドでも200行以下が目安とされており、「短い地図」にとどめて詳細は別ファイルへ逃がすのが鉄則です。 - スキル(Skills): 「この業務はこの手順とチェック基準で進める」という手続き的知識をフォルダ単位でまとめ、必要な局面だけ読み込ませます。詳しくはClaude Codeの基本機能まとめでも解説しています。
- 権限境界と承認ゲート: 「本番DBの変更やファイル削除は人間の承認なしに実行しない」といった制約です。 指示文で「気をつけて」とお願いするのではなく、環境側の権限設定で不可能にしておきます。この安全設計の具体策は、次回の記事「バイブコーディングで初心者が踏み抜く5大セキュリティ地雷」で詳しく扱います。
② センサー(事後検知):ズレを止める関所
AIが長いタスクを自律的にこなすほど、途中で3つの「ドリフト(ズレ)」が起きやすくなります。**「まだ途中なのに勝手に完了と宣言する」「見た目や仕様が崩れているのに完璧だと報告する」「小さなズレが積み重なって全体が破綻する」**の3つです。
これを防ぐのが、AIの行動の後に働くセンサーです。 センサーには大きく2種類があります。
| センサーの種類 | 具体例 | 特徴・強み |
|---|---|---|
| 計算的センサー(決定的・高速) | 単体テスト、型チェック、リンター、JSONスキーマ検証、最大ターン数・予算上限(ハードストップ) | ミリ秒〜数秒で確実に同じ判定を下す。エラー文に「直し方」を含めるとAIが即座に自己修正する |
| 推論的センサー(意味・視覚検証) | 独立した検証用AIによる採点、Playwright等によるブラウザ実画面のスクリーンショット確認 | 「文脈の自然さ」「デザインの崩れ」「出典の正確さ」など、数値化しにくい品質を見抜ける |
特に重要なのが「完了条件の外部化」と「検証役の分離」です。 Anthropicの長時間開発の研究でも、作業したエージェント自身に自己評価させると甘く採点してしまう問題が確認されており、作る役(Generator)と検証する役(Evaluator)を分け、事前に合意したチェックリスト(スプリント契約)で採点させる構成が有効だと示されています。
「内側」と「外側」のハーネスを混同しない
もう一つ押さえておきたいのが、**ツールが標準で持つ「内側(Inner)のハーネス」**と、**使う側が自社向けに組む「外側(Outer)のハーネス」**の区別です。
Claude CodeやCodexといった現代のツールはツール呼び出しの制御、ファイル検索、コンテキスト圧縮(/compact)といった「内側のハーネス」をすでに備えています。
私たちがゼロからエージェントの実行エンジンをプログラミングする必要はありません。私たちが設計すべきなのはその外側にある「自社のルール・スキル・承認ゲート・検証スクリプト」という外側のハーネスです。
4. 2026年後半の教訓:「重すぎるハーネス」という罠
ここまで読むと、「では、細かい手順分岐も検証もサブエージェントも、最初からガチガチに作り込むほど良いのか」と思われがちです。 しかし、2026年後半にかけてAI界隈で大きな議論になったのは、まさにその逆、「ハーネスの作り込みすぎ(オーバーエンジニアリング)」という罠でした。
モデルが賢くなるほど、過剰な制御は足かせになる
第1節でも触れたPhilipp Schmid氏はAI開発における「苦い教訓(The Bitter Lesson)」として、2026年に起きた象徴的な事例を挙げています。
- Manusは硬直した仮定を取り除くため、半年でハーネスを5回作り直した
- LangChainは「Open Deep Research」の構成を1年で3回再設計した
- Vercelはエージェントに渡していたツールの80%を削除したところ、ステップ数もトークン消費も減り、かえって高速かつ正確に動くようになった
さらに2026年9月にはReplitが「Free the models(モデルを解放せよ)」として固定ワークフローを排する方針を示しています。
参考資料
Free the models: Harness design at the frontier
Model routers are everywhere right now, but they have a fundamental limitation. No matter if based on advanced heuristics or a small model that reads each turn and picks which LLM to use, a router will always be less capable than the model it’s choosing for. Replit Agent lets the model decide instead.
replit.com
続いて10月にはAnthropic自身が「ドメイン別に細かく分けたサブエージェントを統合し、スキルを持たせた単一エージェントループにしたほうが品質・コスト・速度のすべてで優れるケースが多い」と報告しています。
参考資料
Building agents: When to fold subagents into your main agent loop
When to consider using fewer subagents and how to migrate the into your main loop.
claude.com
なぜこんなことが起きるのでしょうか。理由はシンプルです。ハーネスに書かれた制御の多くは、「その時点のモデルが自力でできなかったこと」を補うための仮設の環境だからです。Anthropicも前掲の長時間開発の記事で、Sonnet 4.5の時代に「コンテキスト不安」対策として必須だったコンテキストリセットの仕組みがOpus 4.5以降は不要になり削除できたと明記しています。 モデルの推論力が上がったのに古い制限を残したままにするとかえってモデルの自律的な軌道修正を邪魔し、トークンコストと待ち時間だけを膨らませてしまいます。
この「単一ループ+Skills」と「サブエージェント分離」の境界線については、サブエージェントは増やすほど弱くなる? | Anthropicが勧める「単一エージェントループ+Skills」という設計で詳しく解説しています。
それでも残すべき「3つの核」と Build to Delete
では、モデルが進化する時代に、私たちはハーネスの何を残し、何を捨てるべきでしょうか。
- 捨てる前提で作る(Build to Delete): 「ステップ1の次は必ずステップ2へ進む」といった細かい手順の強制や、役割だけの過剰なサブエージェント分割はモデルが賢くなればいつでも剥がせる薄い構造にしておく。
- それでも残すべき3つのポイント:
- 決定論的な境界と安全ゲート: 権限制限、本番変更の承認、最大回数・予算上限(モデルがどれだけ賢くても100%の安全保証はないため)。
- 客観的なセンサー(テスト・実物照合・独立検証): 出力が仕様や一次情報に合致しているかを確認する関所。
- 組織固有のコンテキスト(Skills・判断基準): モデルが事前学習では絶対に知り得ない「自社のルール・顧客文脈・品質基準」。
自社の仕事の進め方をMarkdownファイル群(外側のハーネス)として切り出しておけば、特定のAIモデルに縛られることもありません。
実際KCPでも、最上位モデルの提供終了に合わせて判断基準や手順を後継モデルへ1日で移植した際、業務ハーネス側は何一つ変えずにそのまま頭脳だけを差し替えられました。 この具体的な手順はClaude Fable 5をOpusに「転移」するにまとめています。
5. KCPでの実例 ― ブログ執筆を支える「軽量ハーネス」の中身
実際にKCPとしてどう組んでいるのかをお見せします。 KCPがオウンドメディアの記事執筆のために組んでいるハーネスは複雑なプログラムを一切使わず、プロジェクト内に置いたたった5つのMarkdownファイルだけで構成されています。
.claude/
├── skills/kcp-blog-writer/
│   ├── SKILL.md                  # 企画〜検証の7ステップと歯止め(中核)
│   └── references/
│       ├── style-guide.md        # 文体・構成の型、NG表現ルール
│       ├── seo-workflow.md       # 検索意図分析+SEO/LLMO最適化
│       └── quality-rubric.md     # 品質の採点基準(4観点)
└── agents/
    └── kcp-blog-checker.md       # 独立採点する検証専用エージェント
前節で述べた「やりすぎない設計」をそのまま形にした構成です。役割別のサブエージェントを何体も並べるのではなく、執筆は単一のループ(Maker)で完結させ、独立した検証役(Checker)だけを分離しています。
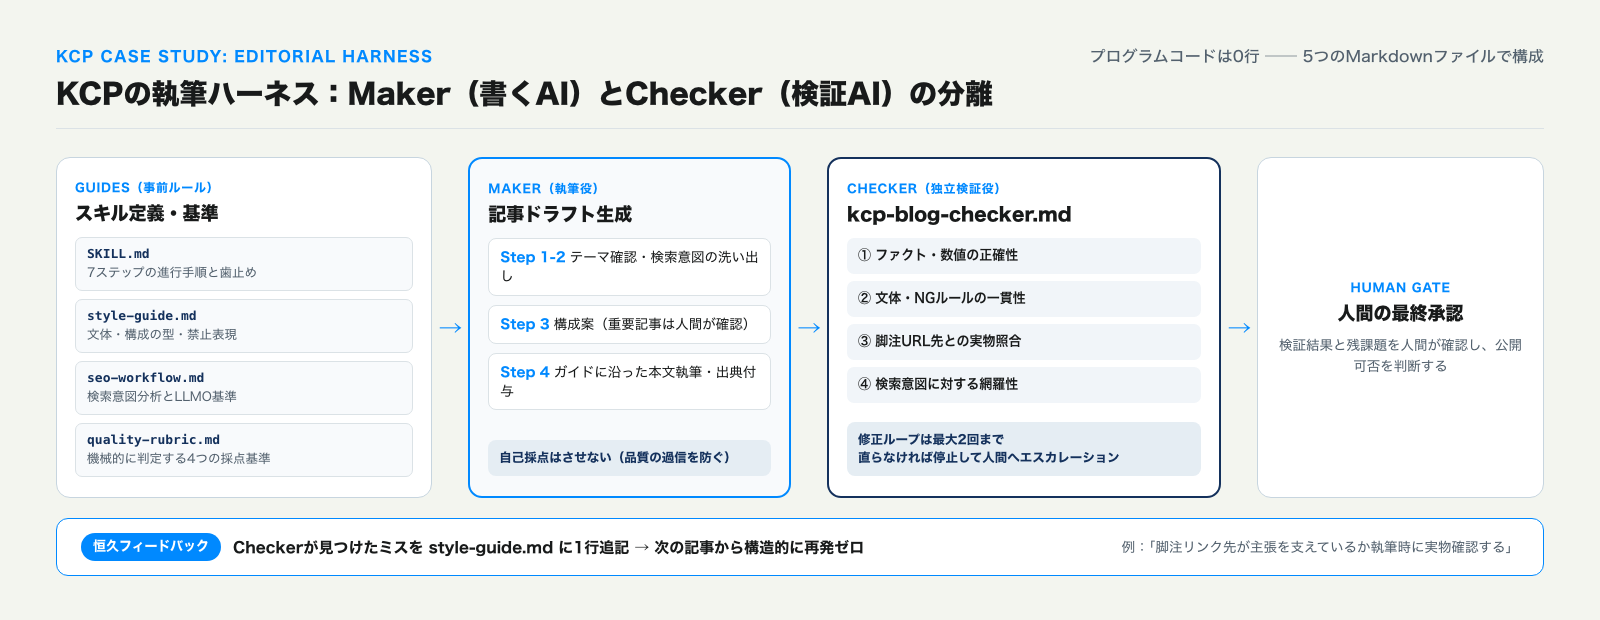
「ガイド」と「センサー」の配置
5つのファイルをガイドとセンサーの枠組みで整理すると、それぞれの役割がはっきり見えます。
- ガイド(事前制御):
SKILL.md: テーマ確認 → 検索意図の洗い出し → アウトライン作成 → 執筆 → 検証 → 修正 → 人間承認という7ステップと、「1回の起動で記事は1本まで」といったガードレールを定義しています。style-guide.md/seo-workflow.md: KCPの過去記事から抽出した文体の型(「ですます基調に断定を混ぜる」「数値・固有名詞・出典を明記する」)、やってはいけない表現(英語スローガンだけで締める、〜のですの多用など)、AIに引用されやすい定義の書き方を記載しています。
- センサー(事後検知):
quality-rubric.md&kcp-blog-checker.md: 原稿が完成したあと、**書いたAI(Maker)とは別のAI(Checker)**が「ファクト・数値の正確性」「文体・NGルールの一貫性」「脚注URL先との実物照合」「検索意図に対する網羅性」の4観点で独立して採点します。「自分で自分を採点させない」という一手だけで、手抜きや過大評価が目に見えて減ります。- ハードストップ: 修正ループは最大2回まで。2回直しても合格しない場合は自動で停止し、残課題を人間へ引き渡します。
そして最も大事なのが、この仕組みを育て続けることです。Checkerが見つけたミスはその記事で直して終わりにせず、style-guide.md などのガイドへ1行追記します。たとえば「脚注のリンク先が本文の主張を本当に支えているか、執筆時に実物を確認する」というルールを足せば、次の記事からは同じ種類のミスが構造的に起きなくなります。
6. 経営者・非エンジニアのための「最初のハーネス」の始め方
最後に経営者や事業責任者にとってハーネスエンジニアリングが何をもたらすか、そして何から手をつけるべきかを整理します。
プロンプトは職人技、ハーネスは組織資産
プロンプトを磨く技術は、どうしても個人の「職人技」にとどまります。上手い担当者が異動したり退職したりすれば、品質も一緒に失われます。
一方でハーネスは、ファイルやルールとして組織に残る資産です。 一度きちんと整えれば、誰がAIを動かしても同じ基準・同じチェック体制で品質を再現できます。そもそも「判断基準」「優先順位」「やってはいけないこと」「確認の手順」を言語化して環境を整える行為は、人間の社員をマネジメントするときに経営者が日頃からやっていることと本質的に同じです。 対象が人からAIに変わっただけで、経営の本業そのものと言えます。
なお、「まずはツールとしての全体像を掴みたい」という方は、Claude Codeとは?「エンジニア用ツール」は誤解? | 経営者が今知るべき理由もあわせてご覧ください。
小さく始める4ステップ
最初から全社業務を網羅する巨大なハーネスを作る必要はありません。失敗するパターンの多くは「いきなり全部を自動化しようとして文脈が破綻する」ケースです。 次の4ステップで、1つの業務から始めるのが現実的です。
- 繰り返す業務を「1つだけ」選ぶ: 日報作成、議事録の整形、問い合わせ一次回答、定型記事の作成など、毎日・毎週発生する定型業務を1つだけ選びます。
- 「短い地図」と「手順書」を1枚ずつ書く:
CLAUDE.mdなどのファイルに「目的・判断基準・NG事項」を200行以内で書き、業務の手順書(Skill)を1つ作ります。 - 「止める・確かめる」センサーを1つだけ置く: AIの「できました」を鵜呑みにせず、「チェックリストと突き合わせる」「別セッション(別ロール)で批判的にレビューさせる」「費用・回数の上限を決める」のいずれかを仕組みとして挟みます。
- ミスが出たらファイルを1行直す: 思い通りの結果にならなかったとき、その場で言い直すだけで終わらせず、「なぜ起きたか」をガイドまたはセンサーへ1行追記します。
内製するか、外部と組むか
ハーネスは「作って終わり」のシステムではありません。第4節で見た通り、AIモデルが賢くなるたびに不要な制御を削ぎ落とし、新しい業務に合わせて育てていく継続的な運用が必要です。
だからこそ、自社にエンジニアやAI推進担当がいて競争優位に直結するなら内製する。 そうでない場合は、**「最初の1つの業務のハーネス(型)をプロと一緒に組み上げ、運用しながら2つ目以降を自社へ広げていく」**という進め方が良いかと思います。 KCPが支援しているのも、まさにこの「実務で回り続ける最初のハーネスを一緒に作る」部分です。
まとめ
ハーネスエンジニアリングは「AIにどう上手く頼むか」から「AIが自然と正しい結果を出し、間違えても止まる環境をどう作るか」への発想の転換です。
- 定義: AIモデル(CPU)を包み込み、動作の信頼性と安全性を担保する外側のインフラ(OS/調理場)を設計・改善し続ける営み。Agent = Model + Harness。
- 3階層: プロンプト(何を聞くか)→ コンテキスト(何を見せるか)→ ハーネス(環境全体・検証・制約)。制御の単位がシステムへと広がる。
- 2つの車輪: 事前制御の「ガイド(短い地図・Skills・権限境界)」と、事後検知の「センサー(決定的なテスト/上限・独立レビュアー)」を組み合わせる。
- 2026年後半の教訓: モデルが賢くなった今、過剰なワークフローやサブエージェント乱立は逆効果になる。「捨てる前提(Build to Delete)」で軽く保ち、安全ゲート・客観検証・自社文脈の3点に集中する。
- KCPの実例と始め方: まずは1業務に絞り、MakerとCheckerを分けた最小の仕組みから始め、ミスが起きるたびに環境を1行ずつ恒久修正する。
「毎回AIが同じミスをする」と感じたとき、次に変えるべきはチャットの文面ではありません。そのミスが二度と起きない「調理場」のルールを、1行だけ書き足すところから始めてみてください。