サブエージェントは増やすほど弱くなる? | Anthropicが勧める「単一エージェントループ+Skills」という設計
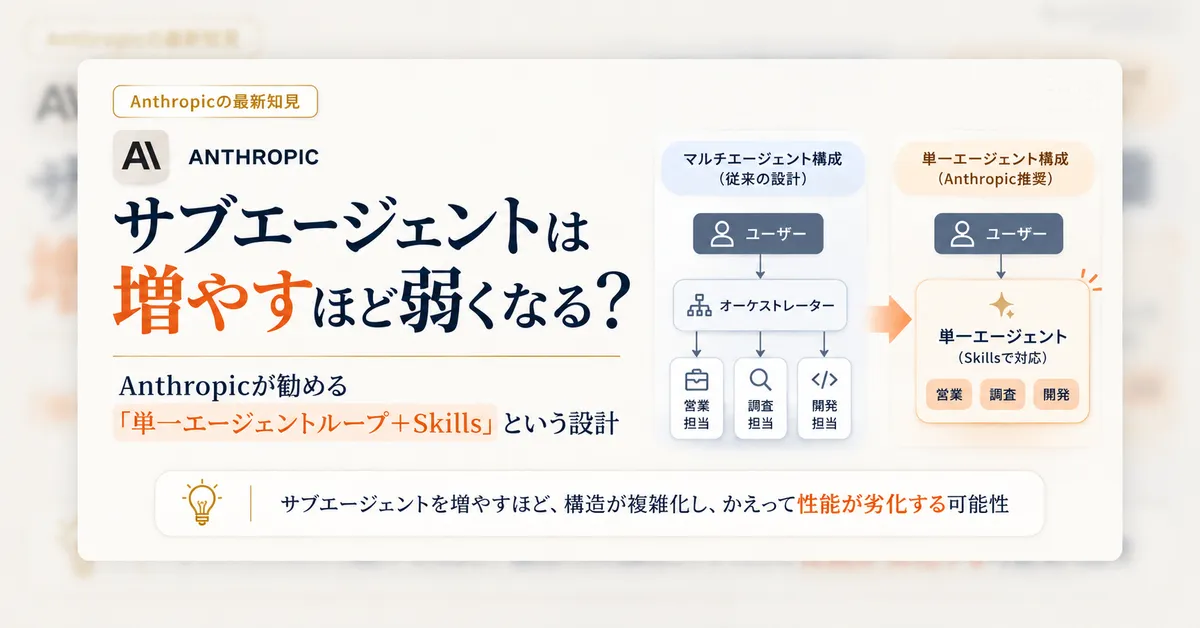
「業務を任せるAIエージェントを作るなら、専門領域ごとにサブエージェントを分けるべきか」
AIエージェントの設計において、営業担当、調査担当、コード実装担当のように役割ごとにサブエージェントを配置し、統括役のオーケストレーターが指示を振り分けるマルチエージェント構成は一般的な選択肢と見なされてきました。
しかし2026年10月22日、AnthropicのApplied AIチームが公開した公式記事「Building agents: When to fold subagents into your main agent loop」は従来の前提とは異なる実測結果を示しています。複数のエンタープライズ導入事例を比較検証した結果、ルーターやプランナー、領域別のサブエージェントをメインのエージェントループへ統合し、スキルを持たせた「単一エージェント」として構成したほうが回答品質、実行コスト、応答遅延のすべてでマルチエージェント構成を上回る事例が多かったという報告です。
サブエージェントを増やすほど構造が複雑化し、かえって性能や保守性が劣化する現象はなぜ生じるのでしょうか。本記事ではAnthropicが報告したマルチエージェント構成における5つの失敗類型、単一ループへ統合できる技術的背景、サブエージェントを依然として残すべき3つの条件、段階的な移行手順、そしてSierra、Replit、Codex、STORMなど他社の実践との相違点をソースの記述に忠実に整理します。
1. Anthropicの発表内容と前提
AnthropicのApplied AIチームが公開した記事は大企業向けエージェント支援の現場で確認された設計パターンの変化を報告したドキュメントです。
比較の対象と3つの構成
同チームは企業の本番環境に導入されたエージェントアーキテクチャについて、主に次の3つの構成を比較しました。
- 単一プロンプト万能型: 1つの長大なシステムプロンプトにあらゆる指示やルールを詰め込んだ構成
- マルチエージェント型(オーケストレータ+専門サブエージェント群): 統括役がタスクを分解し、領域別のサブエージェントへ作業を割り振る構成
- スキル付き単一エージェント(Single agent with skills): 1つのモデル・1つのコンテキストウィンドウでループを回し、必要な専門知識や手順だけをスキルとしてオンデマンドで読み込む構成
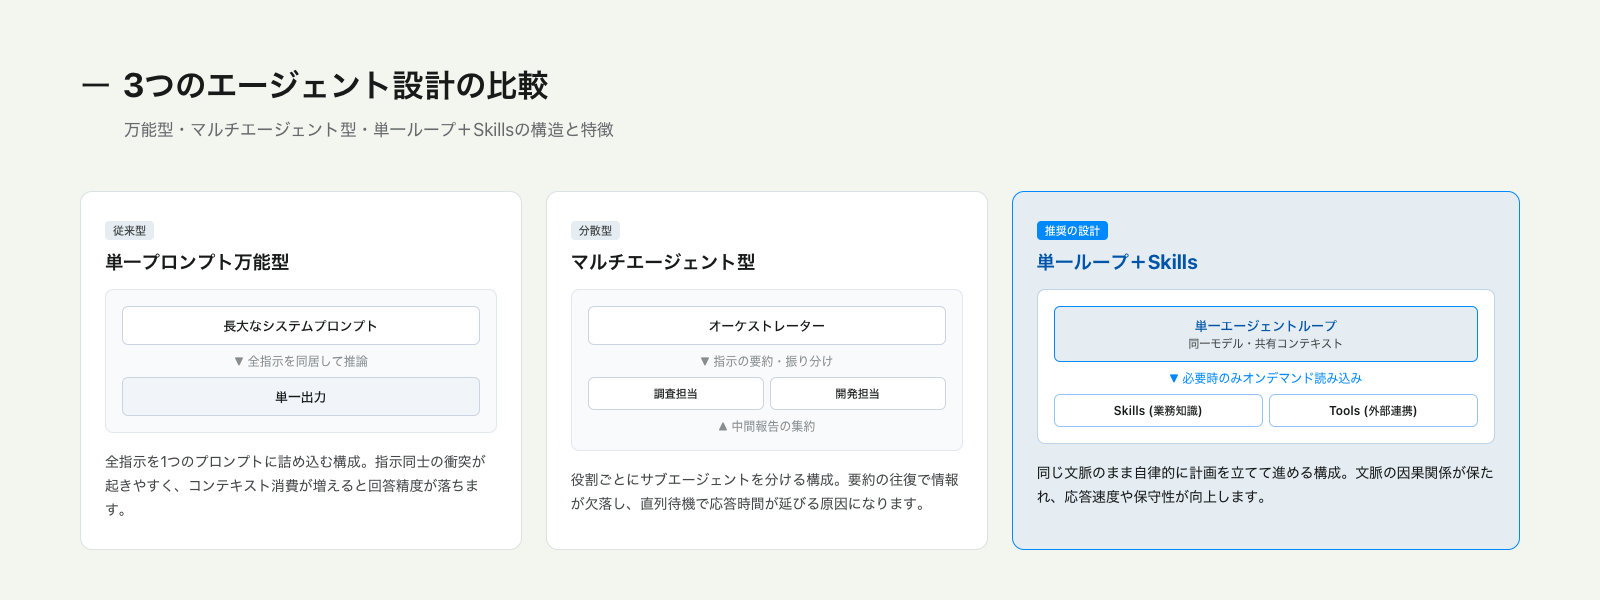
検証の結果、スキル付き単一エージェントは単一プロンプト万能型だけでなく、複雑に組まれたマルチエージェント構成に対しても品質面で優位に立ち、タスクあたりのコストと遅延を低く抑えられた事例が多数確認されたとAnthropicは述べています。ハーネス層で過剰に分割するのではなく、適切な知識パッケージを持たせた単一ループのほうが実用性に優れるという見解です。
本稿で用いる基本用語
議論の前提として、登場する技術用語の定義を整理します。
| 用語 | 本稿での定義 |
|---|---|
| エージェントループ(Agent loop) | モデルがツールの呼び出し結果を受け取り、次の行動(追加のツール呼び出し、ユーザーへの質問、最終回答)を自律的に判断して完遂まで繰り返す実行サイクル |
| サブエージェント(Subagent) | 独自のコンテキストウィンドウ、専用ツール群、個別プロンプトを持ち、統括役(オーケストレーター)によって呼び出される独立したエージェント |
| スキル(Agent Skills) | 特定タスクの手順、ルール、判断基準をフォルダ単位で構造化し、必要な局面でのみモデルへ段階的に開示する知識パッケージ |
| 段階的開示(Progressive disclosure) | すべての情報を初回からプロンプトへ展開せず、メタ情報(名前や概要)のみを常時保持させ、実行時に必要な詳細指示だけをコンテキストへ引き出す設計手法 |
| MCP(Model Context Protocol) | 外部ツールやデータソースへの接続を標準化し、エージェントが必要な機能を安全に呼び出せるようにするオープンな通信規格 |
| ツール検索(Tool search) | 多数のツール定義を常時展開せず、モデルが必要なツールを検索して動的に遅延読み込みする仕組み |
| タスク完了評価(Task-completion eval) | 単一のターンや応答の正しさだけでなく、外部ツールの実行結果を含めて意図したタスク全体が完了したかをエンドツーエンドで測定する評価指標 |
モデルの推論能力向上という前提
Anthropicがサブエージェントの統合を提唱する背景にはフロンティアモデルの急速な進化が存在します。
かつてのモデルは複数の手順や複雑な条件分岐を1回のループ内で一貫して追跡することが困難でした。そのため、人間側がオーケストレーターや意図分類器、固定的なワークフローをコードで作り込み、モデルの判断負荷を分散する必要があった経緯があります。
しかしOpus 4.5、Opus 5.5、Fable 5.1といったモデルの登場により、設計の前提における大きな転換点でした。思考プロセスの常時実行や自己検証機能を備えたモデルは1つのコンテキスト内で自ら計画を立て、ツールの実行結果を確認しながら進捗を自己管理する能力を獲得しています。モデル自身が自律的な計画修正能力を持った結果、ハーネス(外側の制御ソフトウェア)側で細かく組まれていた制御構造の多くが冗長になったという分析です。
2. マルチエージェント構成で生じた5つの失敗類型
企業で複数の製品や業務機能を1つのインターフェースへ統合しようとする際、各専門チームが独自のサブエージェントを作り、中央プラットフォームチームがその上にオーケストレーターを重ねる手法が採用されがちです。
Anthropicはこの現象について、組織の構造がそのままシステム設計に反映される「コンウェイの法則(Conway’s law)」の典型例であり、システムが組織図のコピーになっていると指摘しています。直感的なアプローチに見える一方、本番運用では次の5つの失敗類型が発生すると解説されています。
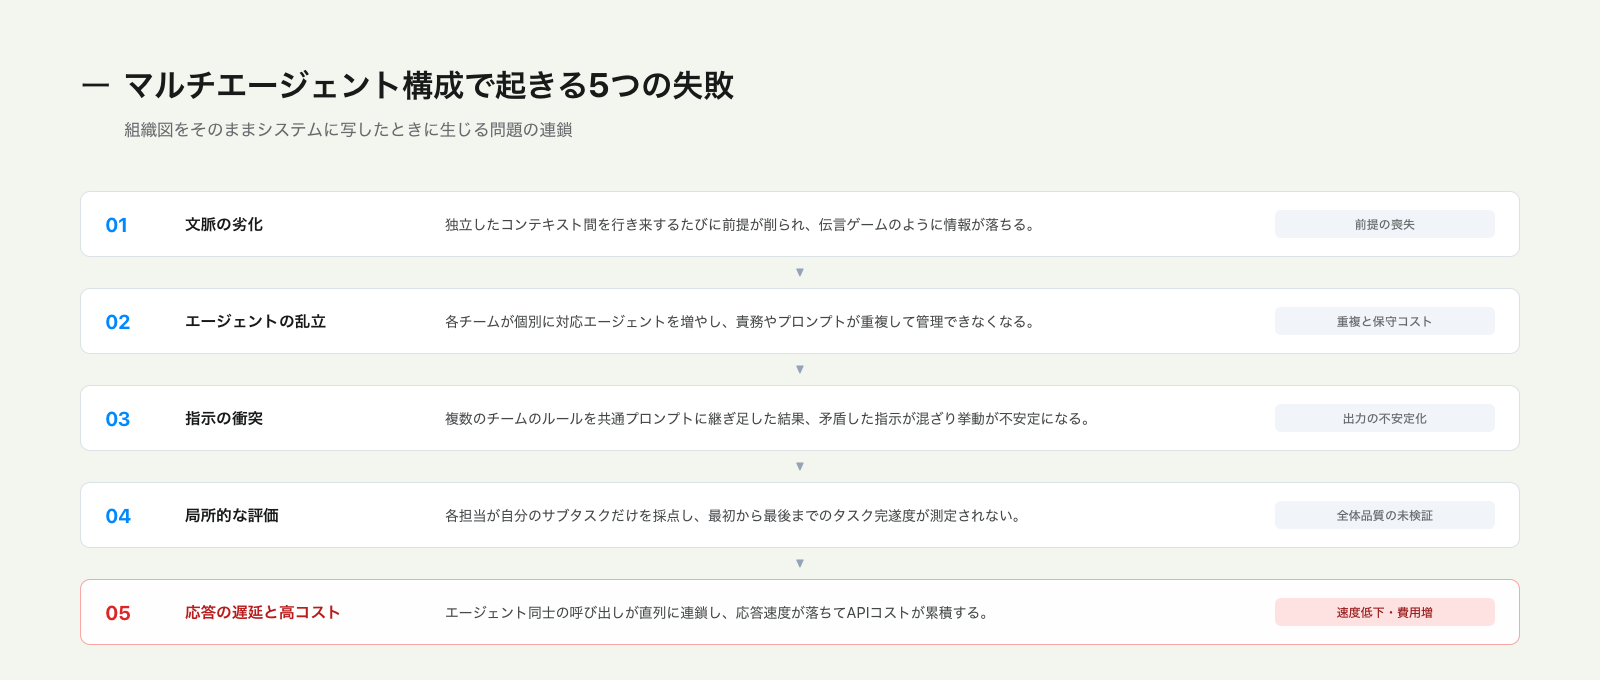
1. コンテキスト管理の劣化(Context management)
サブエージェント構成では各エージェントが独立したコンテキストウィンドウを持つ設計です。統括役とサブエージェントの間でどの情報を引き継ぐかの取捨選択が必要となり、往復の過程で重要な背景情報や細部が脱落します。
エージェント間で情報を受け渡すたびに、引き継ぎごとの精度劣化(情報の忠実度低下)が発生する構造です。問題領域ごとにサブエージェントを機械的に分割すると相互の文脈を把握できず、最終出力の整合性が損なわれる原因になります。
2. サブエージェントの乱立(Subagent sprawl)
各チームが個別の課題を解決するために独自のサブエージェントを開発した結果、組織全体で統一された基準や明確な責任者が不在のまま、機能が重複したサブエージェントが数百個規模にまで増殖します。
エージェントが増えすぎると、どのエージェントが何の責務を持ち、どのプロンプトが最新なのかを全体として管理できません。メンテナンスコストが増大し、あるエージェントの修正が別のエージェントに与える影響の追跡も困難を極めることになります。
3. フランケンプロンプト(The Frankenprompt)
複数のチームが共通の統括システムプロンプトへ自部門のルールや例外規定を1文ずつ追記していった結果、パッチワーク状に指示が継ぎ接ぎされた巨大プロンプト(フランケンプロンプト)が形成されます。
結果として互いに矛盾する指示が同居し、モデルの口調や応答の一貫性が崩壊する結果を招くのが実態です。あるチームの指示を満たすと別のチームの制約に反する状況が生じ、モデルの振る舞いは予測不能な状態に陥る傾向があります。
4. 未検証で局所的な評価(Unvetted, overly localized evals)
各チームが自組織の担当サブタスクに過剰適合させた個別の評価指標(eval)を独自に追加する運用に陥りがちです。その結果、エージェント全体を通した品質を誰一人として検証・維持しない空白地帯が生じることになります。
経営陣や開発責任者は局所的に希釈された部分最適のスコアしか確認できず、システム全体としてユーザー体験が向上しているのかを正確に判定できません。
5. 応答遅延の増大(Latency)
マルチエージェント構成ではオーケストレーターの推論、サブエージェントへの委譲、サブエージェント内部でのモデル呼び出し、結果の集約という形でモデルの実行ループが何層にも入れ子状に連鎖します。
Anthropicの顧客事例では十数個の専門サブエージェントを抱えた顧客対応エージェントにおいて、ブランド体験の一貫性維持が困難になっただけでなく、深刻な応答遅延によってユーザー体験が損なわれる事態に直面した形です。この顧客がマルチエージェントのハーネスを単一エージェントループへ移行したところ、実行速度が約2倍に高速化されたという実測結果が示されています。
3. 単一エージェントループを成立させる3つの技術的基盤
マルチエージェント構成で生じていた問題を回避し、1つのループに統合できるようになった技術的背景は次の3点に集約される論理です。
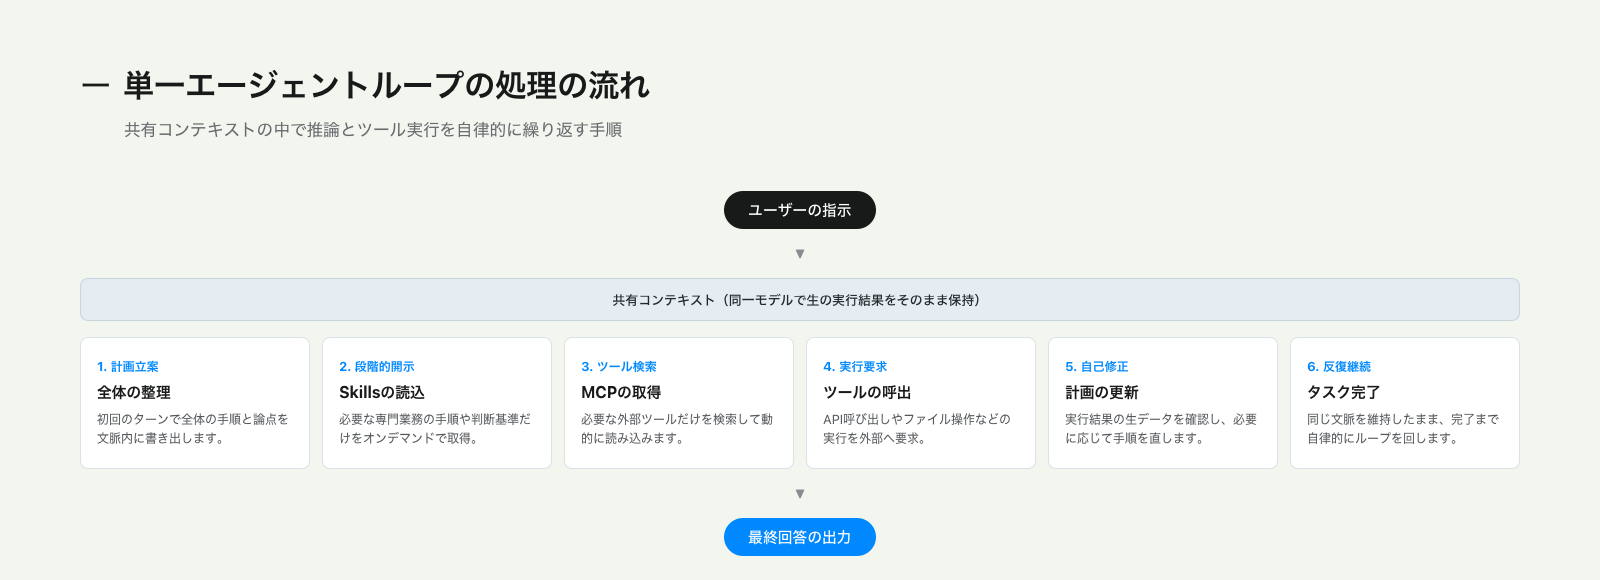
1. 共有コンテキストによる回答精度の向上
長時間稼働するエージェントでは複数の異なるタスクから得られた文脈が同一のコンテキストウィンドウ内に維持されていることが品質向上に直結します。
先行する各ステップの生の結果を直接確認したエージェントは各事象の因果関係を正確に接続できます。サブエージェントから返される要約された中間報告をつなぎ合わせるよりも、はるかに詳細で洞察に富んだ回答を生成可能です。コンテキストの受け渡し回数が減るため、情報の欠落も根本から防止されます。
2. 段階的開示によるコンテキスト肥大化の抑制
単一ループへの統合において懸念されるのがプロンプトの肥大化による性能低下です。この課題を解決する仕組みがスキルとツール検索による「段階的開示(Progressive disclosure)」にあります。
Claude Codeの基本機能やSkillsの内部構造については本サイトの解説記事「Claude Codeの使い方・基本機能まとめ」でも詳述しているように、スキルは3段階の階層構造を持っています。
- 第1階層(YAMLフロントマター): 名前と概要説明のみ。常時プロンプトに常駐し、モデルがスキルの存在を検知する目印となる
- 第2階層(SKILL.md本文): モデルが当該スキルを必要と判断した段階で初めてコンテキストへ展開される
- 第3階層(参照ファイル群): スキルディレクトリ内の補助ドキュメント。必要な場合のみ個別参照される
ツール群についても数十個の定義を初回からすべて読み込むのではなく、ツール検索によって必要な機能だけをオンデマンドで読み込む設計です。
この段階的開示の導入により、Claude Codeの高度なモデル向けシステムプロンプトは80%以上削減されました。最初から巨大なプロンプトを抱え込まずに多様なタスクをこなせる環境が整ったため、コンテキスト肥大化を避ける目的でサブエージェントを分割する必要性が大幅に低下したという経緯です。
3. モデル自身の自律判断力と推論機能
Opus 4.5以降のモデルは1つのループの中で人間が想定していた以上の判断をこなせるようになっています。Opus 5.5やFable 5.1では思考プロセスをオフにできず、作業の進行状況を自ら言語化しながら中間結果を検証する挙動が標準で組み込まれている仕様です。
Anthropicの現場では意図分類器、固定的な複数ステップ推論パイプライン、ユーザー分類バケット、推奨分岐ロジック、最上位オーケストレーターを何重にも組み合わせたエージェントの設計案が頻繁に持ち込まれていました。しかし検証の結果、それらの固定的な構造のほとんどはモデルが自ら判断できる内容であり、「1つの明確なシステムプロンプト」「4〜5個の薄いデータアクセスツール」「厳格な出力ガードレール」で十分に代替できたという結論に至っています。
目指すべき単一ループのアーキテクチャ
Anthropicが移行先として推奨する単一エージェントループの構成は以下の通りです。
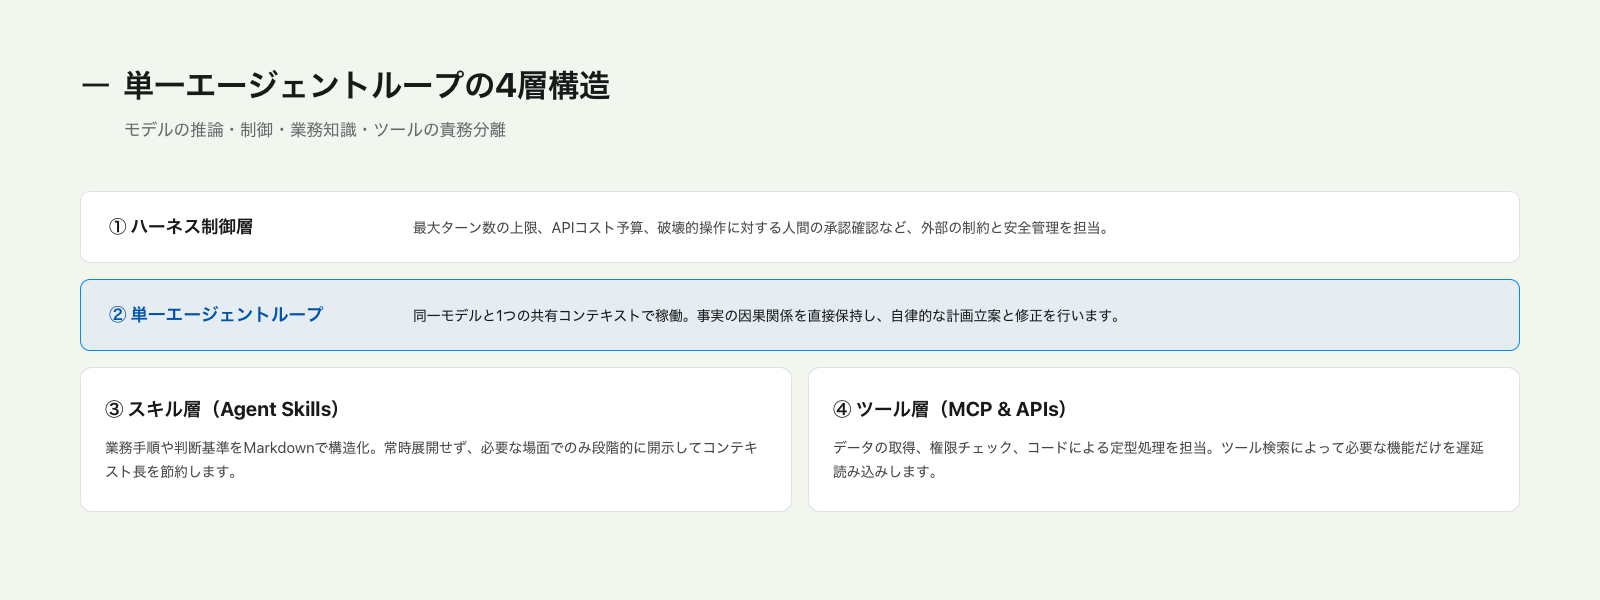
| 構成要素 | 単一ループにおける配置と役割 |
|---|---|
| モデルとコンテキスト | 1つのモデル・1つのコンテキストウィンドウでツール実行ループを自律的に回す |
| 制約管理(ハーネス) | 最大ターン数、コスト予算、危険な書き込み操作のゲート制御はモデル外部のハーネス側で厳密に制限する |
| 計画の立案と修正 | モデルは初回ターンで自ら計画をコンテキスト内に書き出す。ツールの生データ結果を受け取った段階で同一モデルがターンの途中でも計画を修正する |
| 業務手順とルール(Skills) | 実行順序や業務の判断基準はシステムプロンプトではなくスキル側へ切り出す |
| バリデーションと認可(Tools) | 入力値の検証、承認ゲート、メモリ参照、ユーザー権限チェックなどの機械的制約はツール内部に実装する |
| 定型処理(Code) | エンティティ解決、データ構造の成形、ストリーム解析など安価で確実な処理はツール内部のコードで処理する |
固定ルールに基づいて外部コードが計画を書き換える従来のパイプラインは不要となり、計画の策定と実行が同じモデル・同じコンテキストに一元化されます。
4. サブエージェントを残すべき3つの条件と分離基準
単一ループへの統合が推奨される一方、Anthropicは「サブエージェントには依然として明確な存在意義がある」と強調しています。すべてのサブエージェントを廃止すべきではなく、客観的な条件に基づく使い分けの基準が求められる局面です。
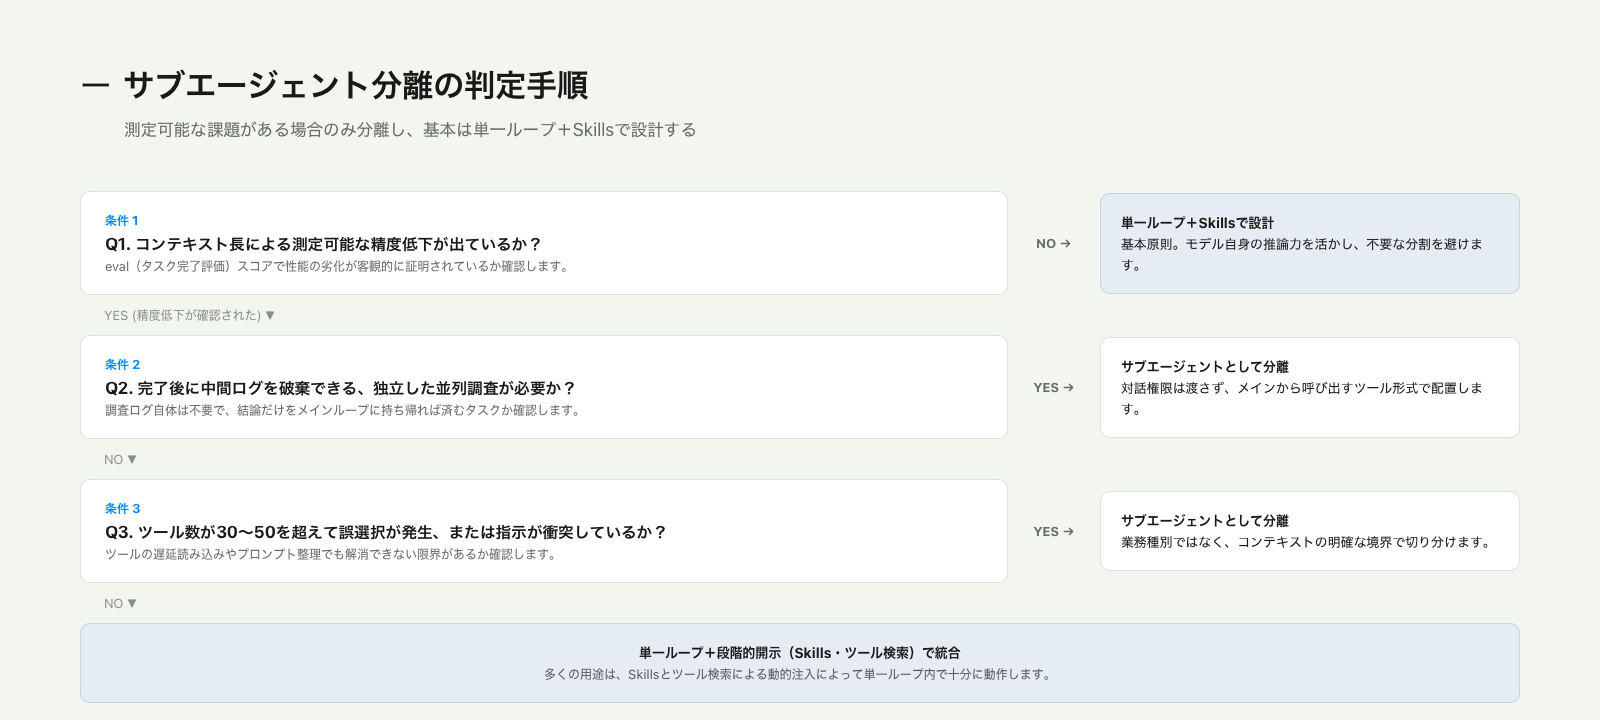
サブエージェントを維持すべき3つの客観条件
Anthropicは次の3つのいずれかに該当する場合に限り、サブエージェントを残すべきであると定めています。
- コンテキスト肥大化による測定可能な性能低下が発生している場合: 単一ループを回し続けた結果、トークン数が膨らみ、回答品質や指示追従性に数値として確認できる劣化が生じている状況
- 使い捨ての独立したコンテキストで並列作業を行う必要がある場合: 調査やコード生成など複数の独立したタスクを同時に走らせ、完了後に中間ログを破棄して結論だけを取り込みたい状況
- ツールの選択ミスが多発する、または指示内容に相反がある場合: 提供するツールが多すぎてモデルが選択を誤る場合や、システムプロンプト内に同時に満たせない矛盾した指示が存在する場合
「問題の種類」ではなく「コンテキストの境界」による分割
サブエージェントを分割する際の基準について、Anthropicは重要な原則を提示しています。業務の「問題の種類(営業、サポート、経理など)」で分けるのではなく、「コンテキストの境界」で切り出さなければなりません。
他システムや親コンテキストからの情報をほとんど必要とせず、作業完了後にコンパクトな結果だけを親へ返せるタスクこそがサブエージェントの適用領域です。具体的には次の3つの候補が挙げられます。
- 独立した調査経路: 他のタスクと文脈を共有せず、単独で完結する探索
- 明確なインターフェースを持つ独立コンポーネント: 入出力の仕様が厳密に定義され、外部の文脈に依存しない処理単位
- ブラックボックス検証: 本体のエージェントが作成した成果物に対し、予断を持たずに独立した視点から検証を行う監査処理
会話の引き継ぎ(ハンドオフ)の原則
サブエージェントを残す場合でも、ユーザーとの対話権限を完全に引き渡す「ハンドオフ」はサブエージェントがユーザーと直接対話する必要がある極めて限定的な状況にとどめる方針が示されています。
それ以外のケースではメインエージェントがサブエージェントを「ツール」として呼び出し、ユーザーとの対話インターフェースはメインエージェントが一貫して保持し続ける構成が推奨される形です。
5. 段階的な統合を進める4ステップと開発体制
既存の本番環境で稼働しているマルチエージェントシステムを一度にすべて単一ループへ書き直すアプローチにはリスクが伴います。Anthropicは評価指標を基準に据えながら4つのステップで段階的に移行する手順を提案しています。
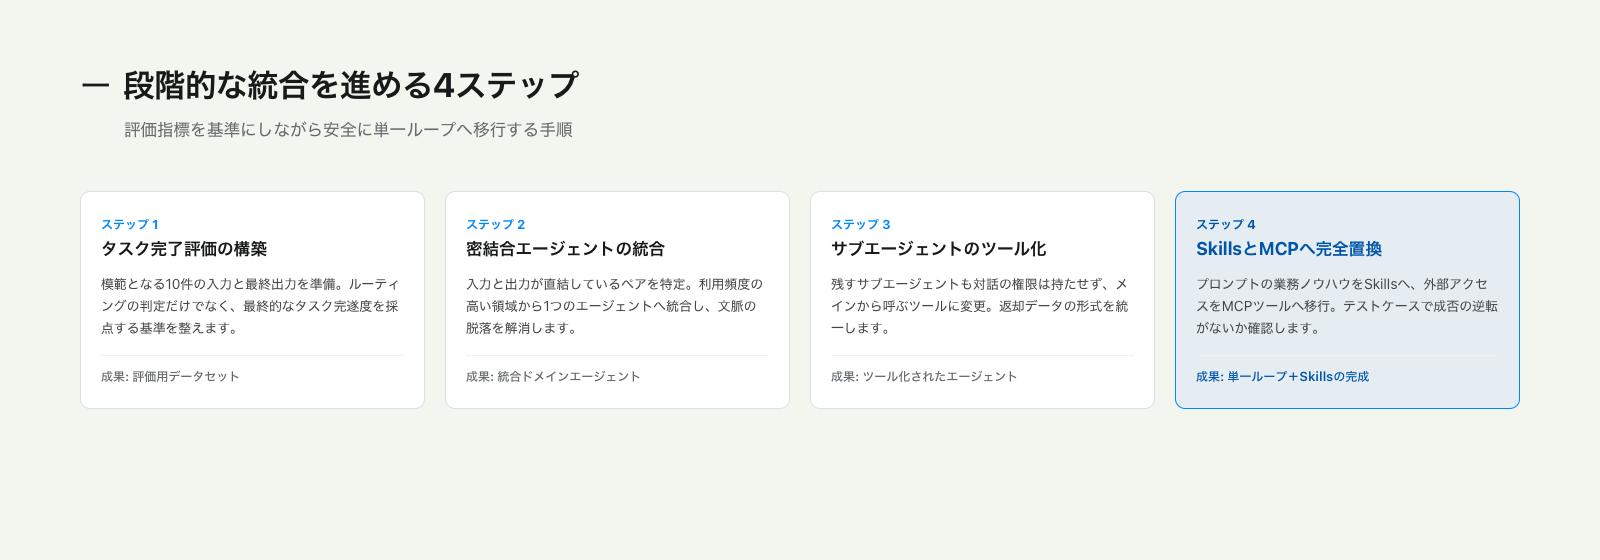
ステップ1: タスク完了評価(Task-completion evals)の構築
統合の第一歩はアーキテクチャ変更の成否を客観的に判定するための評価データセット作成です。
最初は中央チームが所有する10件の「ゴールデンサンプル(模範例)」から開始できます。ルーティング精度の追跡(正しいエージェントやツールを選択できたか)に加え、最終的なタスクが完遂されたかを評価するルーブリック(採点基準)を定義します。
社内システムの再生が難しくユーザー行動の再現が困難な環境では重要なイベントにタイムスタンプを付与して記録しておき、後からテストケースとして再生する手法が有効なアプローチです。
ステップ2: 密結合な領域エージェントの統合(Combining domain agents)
本番トラフィックを分析し、共通のコンテキストを扱い、互いの出力を連鎖させているサブエージェントのペアを特定します。
たとえば第1の専門エージェントの出力が常に第2のエージェントへ引き渡されているような密結合ペアは最初の統合候補として適した対象です。利用頻度が最も高いエージェントから着手し、1つの統合ドメインエージェントへまとめる段取りです。
ステップ3: サブエージェントのツール化(Subagents called as tools)
3つの存続条件に合致して残すサブエージェントについても、オーケストレーターによる分散制御をやめ、メインエージェントが呼び出す「ツール」として再定義します。
この段階ではサブエージェント内部のプロンプトを全面改修する必要がないため、移行の初手として安全に適用可能です。メインエージェント側に共通のレスポンススキーマを定義し、サブエージェントから返ってきた結果を実データと照合する仕組みを導入してタスク完了評価の基準スコア(ベースライン)を確立します。
ただし、ツールとして呼び出している段階では依然としてネストしたモデルループによる応答遅延や、各サブエージェントの個別プロンプト管理の負担が残る点に留意する必要があります。
ステップ4: スキルとMCPツールへの完全置き換え
最終段階としてサブエージェントを1つずつ解体し、プロンプトに記載されていた業務手順やノウハウを「スキル」へ、外部APIやシステムを操作していた部分を「MCPツール」へ移行していく方針です。
この移行では全体の総合スコアを見るだけでなく、個別のテストケースで成功・失敗の判定が逆転(フリップ)していないかを確認しなければなりません。
Anthropicがサポートエージェントで実施した実験ではあるサブエージェントを統合したことで遅延は改善されたものの、それまで成功していた処理が失敗するケースが確認されました。メインエージェントが注文検索ツールを保持したため、配送専門エージェントへ配達予定日を確認せずに自前で不完全に回答してしまった事例です。この不具合は2回の試行中1回しか現れませんでした。そのため、各タスクを2回以上走らせて再現性を検証する姿勢が欠かせません。
複数チームで1つのエージェントを共同開発する体制
単一ループ化を進めるにあたり、社内の複数チームが開発に関わり続けるためのガバナンス体制も整理されています。
- 中央の小規模チーム: システムプロンプトの維持とエンドツーエンドの品質評価を一手に担う。新しいツールやスキルの本番投入を審査する
- 領域チームの直接責任者(DRI): 各部門はエージェントそのものを乱立させるのではなく、自領域の「スキル」と「ツール」の開発・保守に責任を持つ
- MCPツールの設計基準: ツール定義がシステムプロンプト内で30〜50個を超えるとツールの選択精度が劣化するため、ツール検索と遅延読み込みを併用する。ツールはAPI単位ではなく「ユーザーの意図単位」で設計し、権限チェックはツール側で処理してモデルが読める明確な拒否理由を返却する
- スキルの保守ツール:
/skill-creator: 新規スキルの生成、既存スキルの構造整理や重複排除を行う/skill-doctor: 各スキルの消費トークンコストや利用頻度を測定し、使われていない不要なスキルを削除する
- ナレッジベースの配置: 規程や仕様書などの参照情報はコードによってプロンプトへ機械的に事前展開せず、検索ツールの背後に置くかスキル内の参照ファイルとして同梱する
また、Anthropicはこうした移行作業を支援するツール群として「migration kit(single-agent-loop-kit)」を提供しています。このキットでは/claude-api build-eval(評価セット作成)、/claude-api prompt-audit(古いモデル向け指示の検出と修正)、/claude-api hillclimb(評価指標に基づく反復改善)、/claude-api cost-optimize(コスト・遅延の最適化)といったコマンド群を連携させて段階的な移行作業を進められる仕様です。
6. 他社・他プロジェクトの実践との比較
単一エージェントループを重視するAnthropicの立場に対し、AIエージェントの最前線では多様な設計思想が提示されている状況です。各社・開発者の公開情報を比較し、その背景にある力学を整理していきます。
なお、CodexとClaude Codeの思想や基本機能の全体的な差異については本サイトの比較記事「CodexとClaude Codeの違いを徹底比較」でも取り上げています。本節ではマルチエージェントおよびループ設計の観点に絞った比較検討を進める構成です。
5つの設計思想の比較表
各ソースの発信者、公開日、中核となる主張を整理した比較表は以下の通りです。
| 主体 / プロジェクト | 出典と発信者 | 主な設計思想 | サブエージェントの扱い |
|---|---|---|---|
| Anthropic | 公式記事(Applied AI team、2026-10-22) | モデルの推論進化とSkillsの段階的開示を前提に、単一ループへ統合する | 3条件(コンテキスト肥大化、使い捨て並列化、指示競合)に該当する場合のみ例外として維持 |
| Sierra | Neil Rahilly氏(VP of Engineering、2026-07-10) | 役割別エージェントを全廃し、単一エージェント(Pinecone)へ集約 | 業務は部門をまたぐため役割分割は破綻する。1つのエージェントが全社文脈とMCPを統括する |
| Replit | Michele Catasta氏ら(AI team、2026-09-30) | 固定ワークフローを排し、委譲判断と推論の深さをモデル自身に委ねる(Free the models) | ハーネスが強制せず、メインループがタスク難度に応じてサブエージェントの規模・推論量を動的に決定 |
| Codex Multi-Agent V2 | pvncher氏(2026-07-25) | 同一モデルファミリー内で推論強度を変え、役割分担と直接通信を行う | Scout(低推論)、Worker(中推論)、Smart worker(高推論)に分け、エージェント間通信で自律協調 |
| STORM Skill | Nate Herk氏(2026-06-29) | 5つの専門視点による調査と、独立したエージェント群による事実検証 | 5つの視点レンズで並列調査し、さらに6体の別エージェントで反証・事実確認(Adversarial review)を実施 |
共通する潮流と根本的な相違点
各者のアプローチを突き合わせると、現代のエージェント設計における共通認識と分岐点が浮き彫りになります。
共通点: 人間による固定ワークフローの排除と文脈重視
いずれの立場も、人間がコードで細かく条件分岐を作り込んだ硬直的なワークフロー(意図分類器や固定パイプライン)から脱却する方向性で各社の見解は一致しているのが実情です。
SierraのNeil Rahilly氏はサポート(PINE)、アナリスト(Pinewood)、エンジニア(Pinecone)、営業(Reggie Jr)と役割ごとに分けていたエージェント群をすべて単一の「Pinecone」へ統合しました。「企業の本質は部門ではなく一連の仕事(Jobs to be done)であり、最も価値ある仕事は部門をまたいで発生する」という同氏の主張はAnthropicの「組織図のコピーからの脱却」と完全に軌を一にする考え方です。知能そのものよりも企業固有の文脈(コンテキスト)こそが真のボトルネックであるという指摘も共通項と言えます。
相違点: 委譲の決定主体と分割の動機
一方で「誰がサブエージェントへの委譲を決めるのか」「なぜ分けるのか」という論点ではアプローチの分岐が見られます。
-
委譲の決定主体(人間かモデルか): Anthropicはアーキテクチャ設計としてまず単一ループを基本とし、人間が評価指標に基づいて慎重にサブエージェントを削ぎ落としていく方針です。 対照的にReplitはリッチ・サットンの「苦い教訓(The Bitter Lesson)」を引き合いに出し、委譲のルールを人間が定義すること自体を避けるアプローチを採用しています。Replit Agentではメインエージェント(コアループ)自身にサブエージェントのサイズ(Small/Standard/Large)や推論エフォート(思考の深さ)を決定させ、モデルの自律判断によって並列処理や委譲を行わせる設計です。
-
推論強度による効率化(Codex Multi-Agent V2): Codexの実践例ではコンテキストの肥大化対策に加え、「推論コストの配分」を目的としてサブエージェントを位置づけています。軽量なGPT-5.6 Sol Lightを読み取り専用のScoutとして並行探索に走らせ、難度の高い局面でのみ高推論のSmart workerを投入してトークン消費を抑えながら精度を高める構成です。中央の統括役を介さずエージェント同士が直接メッセージを送り合う仕組みを採用している点も独自の工夫と言えます。
-
敵対的検証としての分離(STORM Skill): Nate Herk氏が公開したSTORM Skillでは1つのプロンプトでは必ず生じる認知の盲点を防ぐため、あえて5つの専門レンズ(実務家、学者、懐疑派、経済学者、歴史家)というペルソナにコンテキストを分離しています。収集された情報に対して6体の別エージェントを動員し、一次情報との照合や反証を行う「敵対的ピアレビュー」を実施する構造です。 このSTORMの手法はAnthropicがサブエージェントを残すべき条件として挙げた「ブラックボックス検証」や「独立した調査経路」の実例に合致します。本体の生成プロセスからコンテキストを意図的に切り離し、バイアスのない厳格な検証を実現している事例です。
7. まとめ
AIエージェントの開発現場ではサブエージェントを増やして複雑な協調構造を組むこと自体が目的化しやすい傾向がありました。
しかしAnthropicが示した検証結果は最新モデルの能力向上とSkillsによる段階的開示を取り入れることにより、単一エージェントループのほうが品質、コスト、速度のすべてにおいて優れた結果を出し得る事実を示す実証例です。
AnthropicのApplied AIチームは記事の結びにおいて次のように述べています。
「どのアーキテクチャを選ぶか以上に重要な原則は、計測し、一度に1つだけ変え、検証に耐えたものを残すことだ(That makes any one architecture less important than the principle behind it: measure, change one thing at a time, and keep what holds up.)」
最初から壮大なマルチエージェントシステムを構築するのではなく、まずは小さなエンドツーエンドの評価セットを作成し、単一ループを基準として運用を始める姿勢が合理的です。測定可能な性能低下や明確なコンテキスト分離の必要性が確認された場合にのみ、慎重にサブエージェントを切り出していくアプローチが推奨されます。
参考資料
本記事の執筆にあたり参照した一次情報および関連資料です。
公式発表・ガイド
- Anthropic Applied AI team, 「Building agents: When to fold subagents into your main agent loop」, 2026年10月22日公開
- Anthropic, 「The Complete Guide to Building Skills for Claude」
- Anthropic, 「single-agent-loop-kit (GitHub)」
企業・導入事例
- Neil Rahilly (Sierra), 「AI-pilling our company」, 2026年7月10日公開
他社・コミュニティの設計思想
- Michele Catasta, Daniel Furman, Jacky Zhao, Vaibhav Kumar, Ed Sioufi (Replit), 「Free the models: harness design at the frontier」, 2026年9月30日公開(X: https://x.com/pirroh/status/2104976589180252218)
- pvncher, 「Practical multi-agent orchestration in Codex」, 2026年7月25日公開
- Nate Herk, 「Stanford’s Method Turns Claude Into a PHD Level Research Team」, 2026年6月29日公開